你家的空调能远程开关,手机能秒连Wi-Fi,那AI呢?以前得租服务器、搭环境、调参数,折腾半个月才跑通一个模型——现在呢?点几下鼠标,选个DCU(算力单位),10秒内拉起训练任务,推理服务自动扩缩容,用多少付多少,像交电费一样清楚。这不是科幻片,是九章云极刚拿下中国信通院‘智算云平台能力评测’全项达标后的日常。
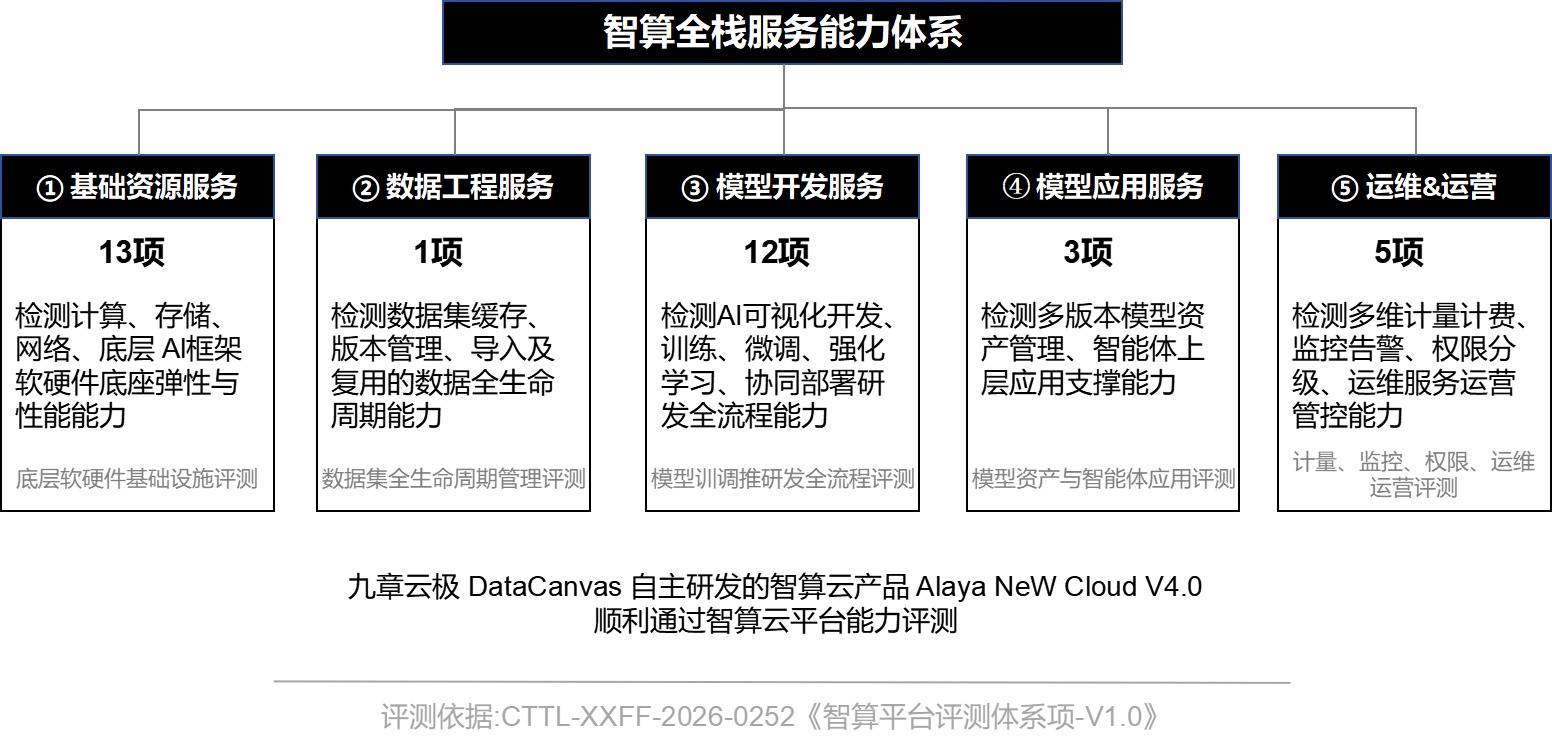
34项硬核测试,覆盖从GPU纳管、数据清洗、模型微调到智能体编排、运维监控的全链路。它不光能管英伟达卡,也兼容国产DCU芯片;不光能跑大模型,还能把MoE架构的Kimi模型训得又快又稳;更关键的是,它把“算力”拆成了可计量的‘度’——1 DCU=312 TFLOPS·h,背后是软硬件协同优化的实打实效能。深朴智能用它做具身机器人训练,开发周期直接砍掉75%;Kimi靠它扛住百万级并发推理,SLA稳在99.99%。说白了,它不是卖服务器,是在运营一座‘AI工厂’。
这座工厂有两条流水线:训练工厂负责‘造模型’,用强化学习把通用大模型‘冶炼’成懂法律、会写代码、能控机器人的专业模型;Token工厂负责‘送智能’,把模型能力封装成标准化、可计费、可审计的Token,企业按需调用,用完即走。投入用DCU量,产出用Token数,中间闭环回流的数据,又反哺下一代模型——越用越聪明,越用越便宜。千倍降本不是画饼,是集群利用率从30%干到85%、资源细粒度切分到毫秒级、弹性扩缩容进阶到‘秒级’的真实账本。
别小看这“毫秒级”三个字。以前扩容要等几分钟,现在模型一检测到流量高峰,系统自动多开三台实例——还没等用户刷完朋友圈,新算力已经就位。这种反应速度,让直播电商的实时商品推荐、金融风控的毫秒级反欺诈、甚至急诊室AI辅助阅片,都从“理论上可行”变成“今天就能上线”。信通院报告里有个细节:平台在突发流量下,资源调度延迟低于80毫秒,比行业平均快4倍。这不是参数堆出来的,是把Kubernetes调度器重写了一遍,又给DCU芯片写了专属驱动层。
更实在的是省钱逻辑。某省级政务云原来用传统GPU集群跑OCR识别,每月固定支出23万,空闲时GPU利用率常年压在18%以下。换上九章云极后,按Token计费,只在市民上传身份证照片那几秒才调用算力,月均成本降到5.2万,还顺手把识别准确率从92.7%提到了99.3%——因为训练工厂持续用新产生的脱敏政务数据微调模型,越用越准。这不是玄学,是平台自带的数据飞轮机制:企业每调用1万个Token,系统自动采样10条高质量推理日志,清洗后回灌进训练池。
当然,有人问:国产芯片适配真那么稳?深朴智能的工程师直接甩出对比图——在同样训练具身机器人抓取动作的任务里,DCU集群跑满32卡,收敛速度比同规格A100快11%,显存占用反而低17%。关键不是“能跑”,而是“敢跑生产环境”:平台内置的故障自愈模块,能在单卡掉线3秒内完成任务迁移,连机械臂控制指令都不丢帧。这背后是37个国产化适配补丁,全在信通院测试报告第28页附录里列得明明白白。
说到底,AI落地卡在哪?不卡在算法多炫,而卡在“用不起、不敢用、不会用”。当算力像自来水一样拧开即来,当模型能力像快递一样下单即达,当每次调用都有明细账单可查——中小企业不用再养一支AI运维团队,医院不用为买卡预算扯皮半年,老师傅也能在产线上点点屏幕,让AI帮他调教新设备。技术下沉的终点,从来不是参数榜单,而是工厂流水线上的一个按钮、社区卫生站里的一次点击、菜市场摊主手机里弹出的“今天鲈鱼销量预测”。
金港赢配资提示:文章来自网络,不代表本站观点。